7 найкращих open-weight LLM для української мови: від 12B до 122B, які реально працюють у приватній хмарі
Я прихильник приватних хмар і цифрової свободи. Не люблю, коли мої дані лежать на чужих серверах і кудись витікають. Те ж саме стосується LLM: ніяких закритих API, сторонніх провайдерів — тільки те, що стоїть у мене в серверній або на орендованому hardware сервері, де я сам встановив операційну систему, додатки та систему захисту.
Офіційної української open weight LLM поки немає (як і закритої), тому я вирішив описати те, що знаю про доступні моделі в контексті підтримки української мови.
Тут виключно про open-weight, які можна повністю запускати на своїй інфраструктурі.
Випробував багато, але залишив лиш ті, у яких бачу потенціал для україномовних завдань, що добре генерують, мають нормальну підтримку інструментів, дають прийнятну швидкість і реальну можливість запуску на конфігураціях які доступні для збірки практично кожному.
Моделі наведені по зростанню кількості параметрів. Спочатку мінімум технічної інформації + мої суб’єктивні коментарі (із практичного досвіду). Потім бенчмарки в таблицях для мінімально доцільної (imho) конфігурації. Побудовані вони з логіки “витиснути максимум із доступного обладнання”. Щодо бенчмарків – прошу ставитися до них критично і сприймати як орієнтовні. Також не сприймайте це як наукову роботу. Описую те, що бачу. Може в теорії або із іншими параметрами конфігурації та в іншу фазу місяця воно могло б працювати інакше.
Щодо використання в tools мається на увазі в проектах агентів/workflows переважно на базі LangChain/LangGraph та в агентах типу nanobot.
Перелік моделей для порівння
Генеративні моделі
MamayLM-Gemma-3 12B
Gemma 3 27B
Qwen3.5-35B-A3B
llama 3.3 70B
Mistral-Small-4-119B
GPT-OSS 120B
Qwen3.5-122B-A10B
Embedding-моделі
Nomic-embed-text-v2
Qwen3-Embedding-8B
bge-m3
Генеративні моделі (LLM)
MamayLM-Gemma-3 12B
Архітектура: Gemma 3 (dense decoder-only Transformer) з continual pre-training + instruction-tuning.
Підтримка української мови: Відмінна. Найкраща у класі. Спеціально донавчена INSAIT на великих українських даних + культурних особливостях. Перевершує всі моделі до 30B в українській і зберігає англійську. Якщо б мала якісний tools була б топ для більшості RAG та супутніх задач. На прикладі цієї моделі видно що спеціалізовані навчальні дані мають значно більше значення ніж розмір моделі.
Підтримка tools: Так (Instruct-версія з function calling). Але нажаль tools не дуже. Як і оригінальна Gemma 3 потребує доробки chat template для повноцінної роботи із інструментами.
Vision: Так. Image-Text-to-Text, v1.0 multimodal.
Підсумок: Найкращий вибір для українських задач (чат, RAG, прикладне застосування). Легка та швидка. Шкода, що розмір не достатній для повноцінної роботи із інструментами у агентах.
Gemma 3 27B
Архітектура: Dense decoder-only Transformer (Gemma 3 family).
Підтримка української мови: Хороша (140+ мов у pretrain, українська добре представлена). Не спеціалізована, але сильна в мультимовності. До появи відкритих моделей 100B+ була базовою для моїх проектів. У проекті AI журналіста добре справлялася із генеруванням статей в різному стилі та інтонації. Хоча в production не використовувалась (перейшли на Gemini).
Підтримка tools: Теоретично так. Але по факту потребує доробки chat template. Стабільно працює з tools/агентами у квантизації мінімум Q8.
Vision: Так (4B/12B/27B — SigLIP vision encoder, image understanding).
Підсумок: Одна з найкращих open моделей 27B за якістю, добре масштабується. Ідеальна як база для донавчання моделей у класі до 30B.
Qwen3.5-35B-A3B
Архітектура: MoE (35B total / 3B active) + hybrid (Gated DeltaNet + linear attention + MoE).
Підтримка української мови: Дуже хороша, 100+ мов, сильна мультимовність. У 2026 розширено до 201 мов і діалектів. Перша китайська відкрита модель у такому розмірі із якісною українською. За рахунок MoE працює швидко. Добре підходить для агентів, що обробляють великі об’єми україномовних текстів. Зараз мій основний вибір у класі. Найкращий баланс якість/вимоги до заліза/швидкість.
Підтримка tools: Так (нативний tool use / agentic). У квантизації менше Q4 працюють не стабільно. Більші кванти – без проблем.
Vision: Так (native vision-language). Краще ніж у Llama/Gemma того ж класу. Було використано у проекті із розпізнаванням зображень, де генерувався опис об’єкту українською за фото із внесенням у базу даних з допомогою tools.
Підсумок: Ефективна MoE — висока якість при низькому споживанні ресурсів на інференсі. Дуже якісний український текст, без логічних помилок чи іншомовних слів. Щодня використовую як оновну модель у Vane (локальний аналог Perplexity) для пошуку, аналізу та узагальнення.
Llama 3.3 70B
Архітектура: Optimized dense decoder-only Transformer (Llama 3 family).
Підтримка української мови: Хороша (мультимовна, покращена відносно 3.1). Порівняно із попередніми моделями українська приблизно такої ж якості. Суб’єктивно трохи більш креативна, що зрештою нормально для її розміру. Однак платою є втрата швидкості.
Підтримка tools: Так. Tools/agents стабільно і без помилок.
Vision: Ні (текстова).
Підсумок: Близька до 405B за деякими бенчмарками. На практиці не використовую. Найнижча швидкість із переліку. Для локального інференсу надто важка.
Mistral-Small-4-119B-2603
Архітектура: MoE (119B total / 6.5B active) з 128 експертами (4 активні на токен) + hybrid (об’єднує instruct, reasoning і coding в одній моделі).
Підтримка української мови: Вважають конкурентом GPT-OSS у reasoning/agentic і кодингу. Модель в цілому добре будує український текст (згенерована дитяча казка має логіку і зміст), мова природна, достатньо креативна, помилки відсутні. Машинний стиль відчувається більше ніж у Qwen.
Підтримка tools: Так (native function calling + JSON output). Добре працює з інструментами, особливо в agentic та coding задачах. Завдання українською розуміє гірше ніж Qwen (що було для мене досить дивним, враховуючи європейські корені проекту), повертає лаконічні структуровані відповіді. MoE-архітектура допомагає стабільно тримати кілька tools одночасно без сильної деградації.
Vision: Так (multimodal). Приймає текст + зображення на вхід, генерує текстовий опис/аналіз. Добре справляється з аналізом документів, діаграм, фото.
Підсумок: Потужна hybrid-модель 2026 року, яка об’єднує можливості Magistral (reasoning), Pixtral (vision) та Devstral (agentic coding) в одному пакеті під Apache 2.0 ліцензією. Дуже ефективна в інференсі завдяки MoE (працює як модель ~6-8B active). Є configurable reasoning mode (від none до high). Пишуть, що швидша за попередників. Добре підходить для локального запуску (в квантизації поміщається на сучасне залізо краще, ніж dense 120B). Дехто у порівнянні з GPT-OSS 120B вважає кращою в європейській мультимовності, але може трохи поступатися в максимальному reasoning на складних бенчмарках. В моїх тестах виявляла меншу креативність в українських текстах ніж GPT-OSS, гірше узагальнювала та частіше забувала контекст. Суб’єктивно українська гірше ніж у Qwen3.5 122B.
GPT-OSS 120B
Архітектура: MoE (117B total / ~5.1B active), оптимізована для reasoning/agentic.
Підтримка української мови: Хороша (мультимовна), сильна в reasoning. Текст має характерний машинний стиль ChatGPT.
Підтримка tools: Так (agentic/tool use). Відмінно.
Vision: Ні (текстова).
Підсумок: Дуже сильна в reasoning і агентах, розроблена OpenAI як open-аналог. Довгий час є моєю базовою моделлю у класі
Qwen3.5-122B-A10B
Архітектура: MoE (122B total / 10B active) + hybrid (Gated DeltaNet + MoE).
Підтримка української мови: Відмінна (100+ мов).
Підтримка tools: Так (native tool use). Добре розуміє завдання українською. Український текст логічний і приємний для читання. В тексті менше відчувається машинної синтетичності.
Vision: Так (multimodal). В реальному проекті ще не випробовувався, але у тестах справлялася дуже добре навіть на фото поганої якості.
Підсумок: Одна з найпотужніших open моделей 2026 року — поєднує розмір і ефективність MoE. MoE-моделі стабільно працюють з 5–7 tools одночасно навіть у Q4. Рекомендую.
Embedding-моделі
Nomic-embed-text-v2
Архітектура: MoE (475M total / 305M active), Matryoshka embeddings.
Підтримка української мови: Дуже хороша (~100 мов, сильна мультимовність). Якщо розмір критичний – цілком надійна модель, з прийнятною якістю.
Підсумок: SOTA для мультимовного retrieval, гнучкі розміри векторів.
Qwen3-Embedding-8B
Архітектура: Dense Transformer (8B), flexible output dim 32–4096.
Підтримка української мови: Відмінна (100+ мов). Моя основна модель для embedding завдань.
Підсумок: Найкраща якість embedding серед доступних моделей, 32k context.
bge-m3
Архітектура: Dense (M3-Embedding: multi-dense + sparse + multi-vector).
Підтримка української мови: Дуже хороша (100+ мов, явно включає uk). Суб’єктивно – трохи поступається Qwen3-embedding.
Підсумок: Універсальна (dense + sparse + multi-vector), SOTA для cross-lingual retrieval.
Короткий висновок
Найкращий баланс українська + швидкість: MamayLM-Gemma-3 12B (найшвидша) або Qwen3.5-35B-A3B.
Найпотужніші за якістю генерації: Qwen3.5-122B-A10B або GPT-OSS 120B (MoE — ідеально для бюджетного обладнання).
Застосування в tools/agents: Практично всі моделі добре справляються - 30B+ у квантизації мінімум Q8, та 100B+ у квантизації мінімум Q4. Різниця у формулюванні тексту та роботі з контекстом. Більші моделі природно працюють краще.
Reasoning + агенти: Qwen3.5-35B-A3B - для швидкості, GPT-OSS 120B – для більшого інтелекту.
Vision: Qwen3.5-35B або Qwen3.5-122B. Вибір залежно від доступних апаратних ресурсів. Якщо є можливість краще вибирати модель із більшою кількістю параметрів. Хоча 35B справляється на мою думку ідеально.
Embeddings: Qwen3-Embedding-8B для максимальної якості, Nomic при обмежених ресурсах.
Тест швидкості інференсу в llama.cpp
Сервер: 2 × Nvidia RTX 3090 + Xeon E5 2680 v4. Загалом 48 GB VRAM + 64 GB системної RAM. GGUF формат.
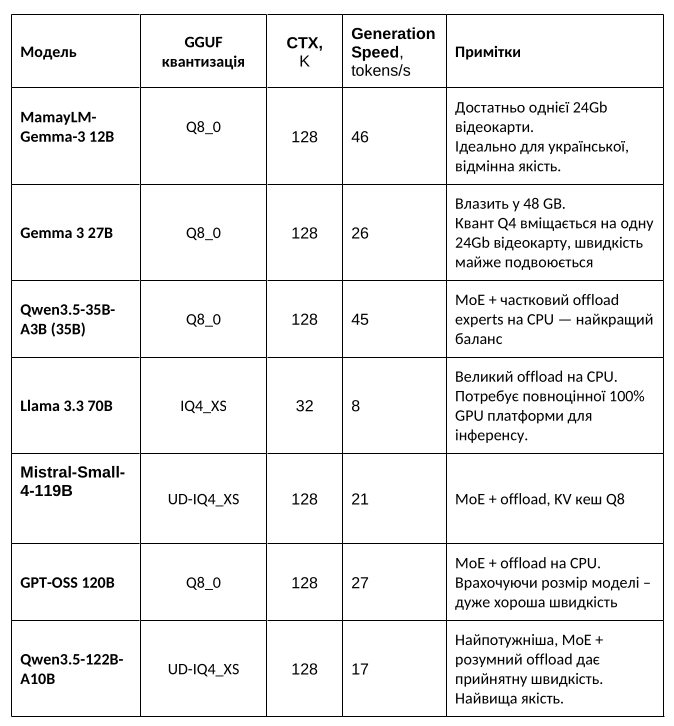
Ключові зауваження для цієї конфігурації (2 × RTX 3090)
Лише 48 GB VRAM — тому для моделей >40–45 GB неминучий hybrid offload на CPU/RAM. Xeon E5 2680 v4 (14 ядер) старий процесор, створює помітний bottleneck. При offload >8–10 шарів швидкість падає відчутно.
Пріоритет Q8 для максимальної якості. Але кінцевий вибір для проекту це завжди пошук балансу якість/швидкість. На практиці найоптимальніша квантизація Q6. Висока якість, оптимальні вимоги до ресурсів. Або мінімум Q4. Нижче – помітна втрата якості, вище – непропорційний до якості ріст вимог до ресурсів. Рідко потрібен виграш 3-4% при витраті пам’яті в гігабайти.
Використовуємо hybrid offload: максимум шарів на GPU, решта — на CPU/RAM.
Використовуючи кванти де є 16 bit шари (імена файлів переважно закінчуються на _XL) враховуйте як швидко їх обробляє ваша система. Наприклад поширена бюджетна карта Nvidia Tesla P40 рахує їх дуже повільно через погану апаратну підтримку FP16.
Контекст 128k (закриває 99% задач і робить модель практичним інструментом, а не дослідним екземпляром). Якщо пам’ять дозволяє – не бачу змісту зменшувати. Хоча для більшості не кодинг завдань достатньо 64k.
MoE-моделі (Qwen3.5 та GPT-OSS) — найкращий вибір: можна offload лише експертні шари на CPU, а основні тримати на GPU. Це дає значно менше падіння швидкості.
64 GB RAM вистачає з запасом навіть для великих моделей з контекстом.
Файли понад 50 Gb. Тому система повинна мати швидкі накопичувачі NVME як мінімум для прийнятної швидкості завантаження.
Спеціалізовані моделі
TranslateGemma
У порівняння не потрапила TranslateGemma — нова відкрита модель для машинного перекладу від Google (січень 2026), побудоване на базі Gemma 3. Вона потребує трохи іншого підходу до оцінки.
Ключові характеристики (коротко):
Розміри моделей: 4B, 12B, 27B.
Підтримка мов: 55 основних мов.
Якість: 12B-модель перевершує базову Gemma 3 27B на бенчмарку WMT24++ (менше параметрів, кращий результат).
Тренування: Двоступеневий процес — supervised fine-tuning на суміші реальних + синтетичних даних (від Gemini) + reinforcement learning з метриками якості (MetricX, AutoMQM).
Мультимодальність: Зберігає можливості Gemma 3, може витягувати та перекладати текст прямо з зображень (без додаткового fine-tuning).
Відкритість: Повністю open-weight, доступні на Hugging Face / Kaggle / Ollama. Легко запускаються локально.
Примітка: Ілюстрація згенерована на тому ж сервері. Модель Tongyi-MAI/Z-Image на базі ComfyUI.
Слово “криза”, написане китайською мовою, складається з двох ієрогліфів: один означає “небезпека”, інший – “можливість